Infraestructura para IA, Deep Learning y LLMs
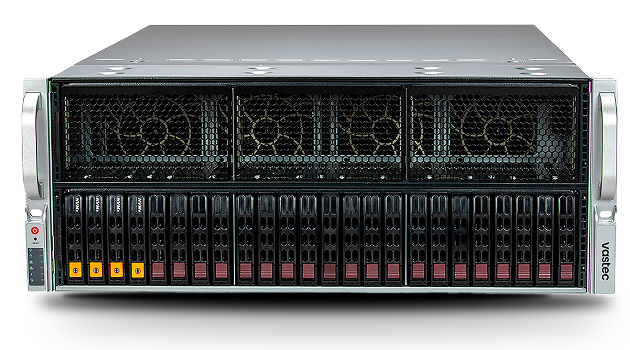
Servidores diseñados íntegramente para alimentar las cargas de trabajo más exigentes del mundo actual. Desde el entrenamiento de Grandes Modelos de Lenguaje (LLMs) hasta la inferencia masiva de visión por computadora, maximizando el rendimiento de sus aceleradores.
Potencia respaldada por tecnología líder
Servidores Vastec configurados con AMD, Intel, Microsoft y NVIDIA para impulsar las operaciones críticas de su empresa.
Línea de Productos
Explora equipos configurables según la capacidad y desempeño que requiere tu empresa.
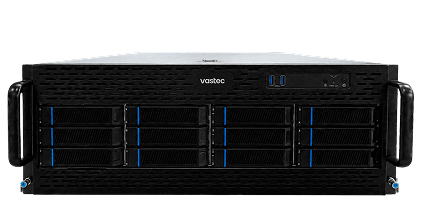
VASTEC SMARTPRO AI TRAINING AT100
-
 2 x Intel® Xeon® 6530P hasta 4.1GHz
-
 256 GB DDR5 ECC RDIMM hasta 2 TB
-
 2 x NVIDIA RTX PRO 5000 Blackwell 48 GB GDDR7 ECC
-
 2 × SSD NVMe M.2 PCIe de 960 GB

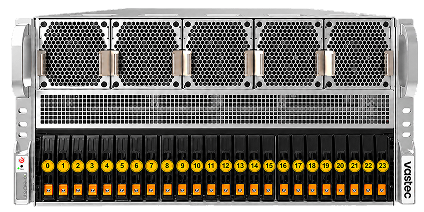
VASTEC SMARTPRO AI TRAINING AT900
-
2 x Intel® Xeon® 6952P hasta 3.9 GHz
-
1.5 TB DDR5 ECC RDIMM hasta 6 TB
-
2 x NVIDIA RTX PRO 6000 Blackwell 96GB GDDR7 ECC
-
4 × SSD NVMe U.2 de 3,84 TB, hot-swap
Cargas de trabajo que puedes ejecutar
Cada solución está optimizada para un conjunto específico de cargas de trabajo, garantizando máximo rendimiento y ROI.
1.ENTRENAMIENTO DE LLMs
Entrenamiento y despliegue de modelos de lenguaje masivos para atención al cliente automatizada, análisis legal o generación de código.
2.IA GENERATIVA
Creación de imágenes, video y audio sintético
3.INFERENCIA EN TIEMPO REAL
Acelera el análisis de genómica y química computacional para proyectos de investigación exigentes.
4.PROCESAMIENTO DE LENGUAJE NATURAL
Procesa información de data lakes, ETL y volúmenes de datos que pueden alcanzar petabytes.
5.CIENCIA DE DATOS Y ANÁLISIS PREDICTIVOL
Analiza simulaciones con postprocesado y renderizado avanzado.Visualiza grandes conjuntos de datos científicos.
6.VISIÓN ARTIFICIAL Y COMPUTER VISIÓN
Optimiza producción, logística y cadenas de suministro.Reduce costos y mejora la eficiencia operativa.
Potencia y escalabilidad para tus modelos de IA
Servidores acelerados por GPU de ultra alto rendimiento, diseñados para entrenamiento de modelos complejos, visión por computadora y procesamiento de LLMs.
Arquitectura Desbloqueada
Nos enfocamos en evitar el cuello de botella entre el procesador Intel, la memoria y las GPUs. Placas base diseñadas para máxima latencia mínima y ancho de banda bruto.
Gestión Térmica Avanzada
El entrenamiento de IA genera calor extremo. Nuestros chasis están diseñados con rutas de aire presurizadas y ventilación de alta capacidad para mantener sus GPUs en la temperatura óptima de Boost las 24 horas.
Stack de Software Listo
Pre-configurados con los drivers CUDA, cuDNN, Docker y frameworks esenciales (PyTorch, TensorFlow) para que sus científicos de datos comiencen a programar desde el minuto uno.
¿Cómo construimos tu solución de IA?
Perfilar el Modelo (Model Profiling)
Analizamos si su carga de trabajo está limitada por la memoria de la GPU (VRAM), la capacidad de cómputo (TFLOPS) o la comunicación entre nodos.
Diseño de Topología GPU
Definimos el número exacto de GPUs por nodo (G100 vs G800) y la infraestructura de red de alta velocidad (InfiniBand o Ethernet RoCE) si requiere varios nodos G800.
Validación Térmica y Eléctrica
Verificamos que su centro de datos tiene la capacidad de enfriamiento y amperaje necesarios antes de encender los equipos.
Stacking y Benchmarking
Instalamos el software base y corremos pruebas de estrés (como ResNet-50 o pruebas de tokenización) para validar que el rendimiento es el esperado.
Preguntas Frecuentes
¿Qué tipo de proyectos de IA puedo ejecutar?
Desde entrenamiento de modelos de lenguaje (LLMs) y visión artificial hasta sistemas de recomendación y análisis predictivo. Compatible con PyTorch, TensorFlow, JAX y todos los frameworks principales.
¿Cuánto tiempo toma la entrega de un servidor?
Para modelos estándar, disponemos de stock inmediato con entrega en 5-7 días hábiles. Para configuraciones personalizadas con GPUs específicas, el plazo puede ser de 4 a 6 semanas.
¿Puedo escalar mi infraestructura en el futuro?
Sí. Nuestras plataformas son modulares: puedes añadir más GPUs, ampliar la memoria RAM y aumentar el almacenamiento sin cambiar de servidor.
¿Los servidores son compatibles con GPUs NVIDIA?
Sí, nuestros servidores son compatibles con las últimas GPUs NVIDIA® para entrenamiento e inferencia, desde modelos de nivel inicial hasta configuraciones de alto rendimiento con múltiples GPUs.
¿Qué GPUs soportan los servidores VASTEC AI?
Contamos con ingenieros especializados en IA e HPC, disponibles 24/7 para resolver incidencias y optimizar el rendimiento de tus cargas de trabajo en producción.
Impulsa tus proyectos de IA con la infraestructura adecuada
Hablemos de tus necesidades y diseñemos juntos la mejor solución en servidores para inteligencia artificial.